0. 模型概述
lukeewin01/SenseVoiceSmall_HeNan是基于阿里开源的iic/SenseVoiceSmall模型使用了600小时数据集训练而来,其中河南方言500小时,普通话100小时。
分为两个版本,一个是开源版本,也就是你现在看到的这个,还有一个是未开源版本。开源版本为训练6epoch,未开源版本训练50 epoch。
1. 模型介绍
SenseVoiceSmall是达摩院语音团队提出的一种高效的非自回归端到端语音识别框架。本项目为SenseVoiceSmall多语种语音识别模型,采用工业级数万小时的标注音频进行模型训练,保证了模型的通用识别效果。模型可以被应用于语音输入法、语音导航、智能会议纪要、通话录音转写等场景中。
2. 模型训练
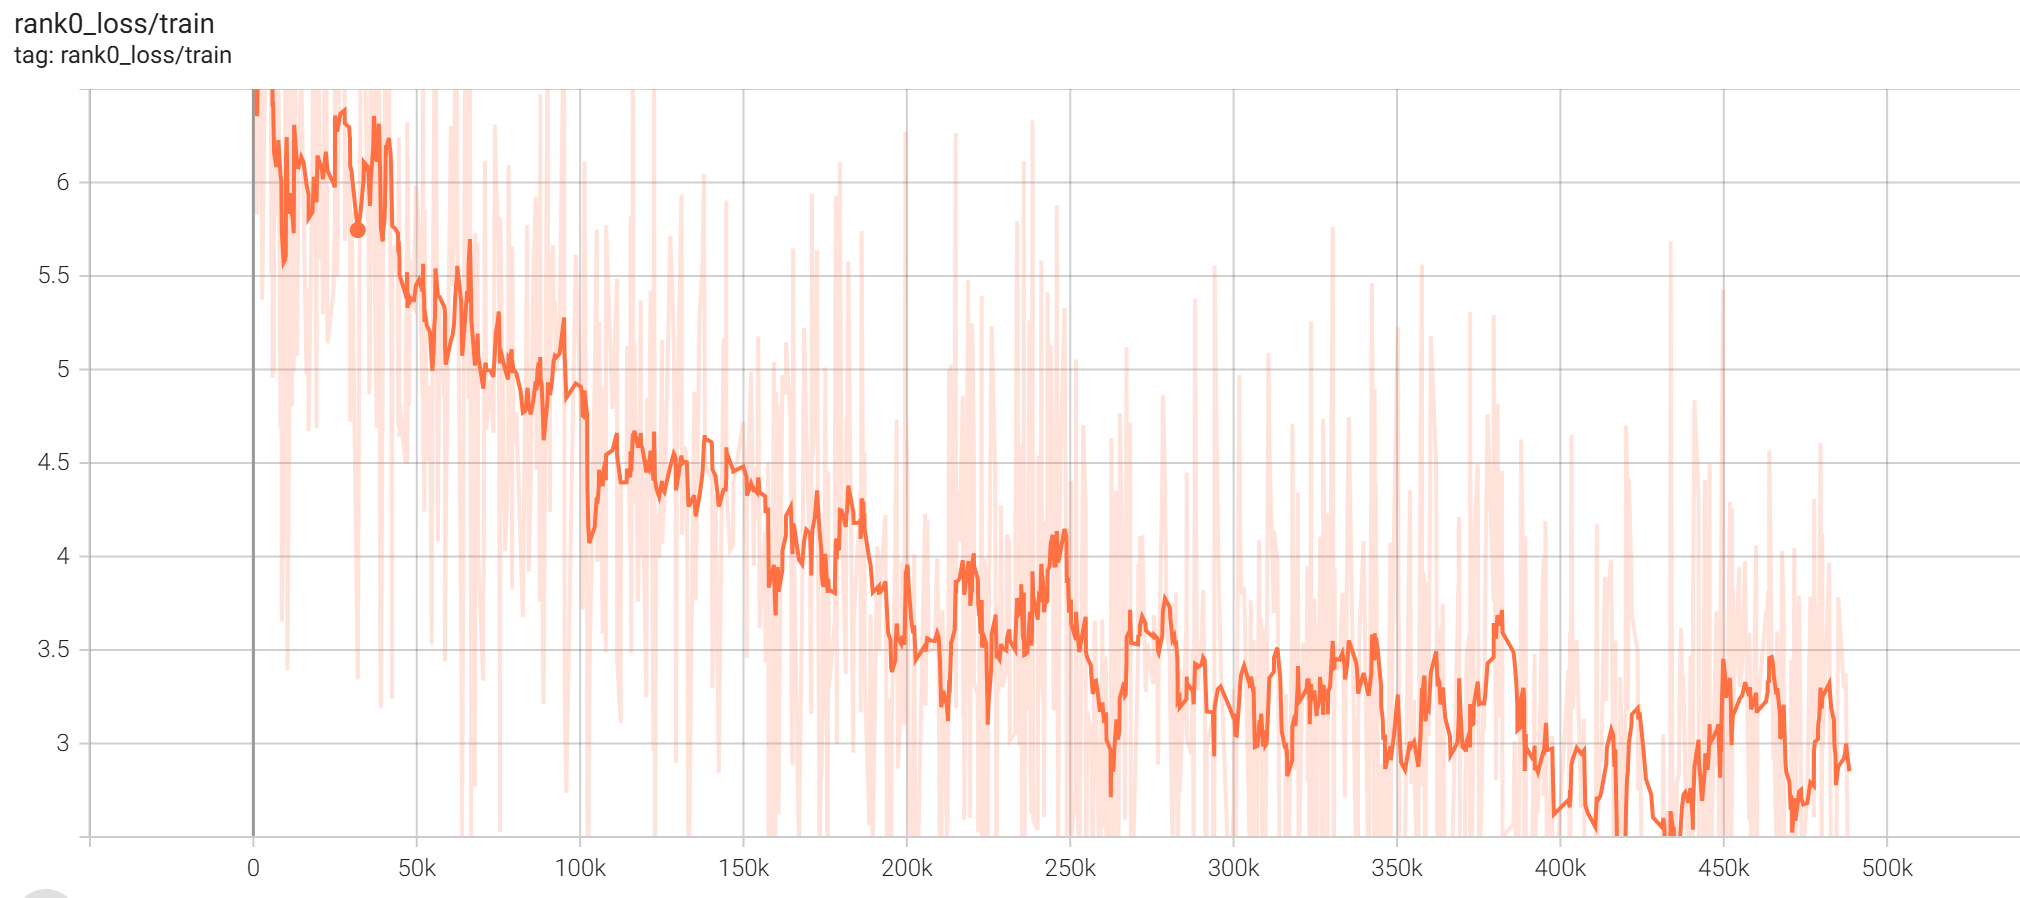
下面为训练过程中截的 loss 曲线变化图,从图中可知,这个模型训练是有效果的。
3. 模型推理
先安装 python 依赖
pip install -U funasr modelscope
安装 cuda 版本的 torch
pip uninstall torch torchaudio torchvision -y
pip install torch==2.3.1 torchvision==0.18.1 torchaudio==2.3.1 -f  https://mirrors.aliyun.com/pytorch-wheels/cu118
下面是推理代码:
# !/usr/bin/env python
# _*_ coding utf-8 _*_
# @Time: 2026/05/04 14:23
# @Author: Luke Ewin
# @Blog: https://blog.lukeewin.top
from funasr import AutoModel
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model_dir = "lukeewin01/SenseVoiceSmall_HeNan"

model = AutoModel(
    model=model_dir,
    vad_model="fsmn-vad",
    vad_kwargs={"max_single_segment_time": 30000},
    device="cuda:0",
    disable_update=True
)

while True:
    audio = input("请输入要处理的音频,如输入exit,则退出程序")
    if audio == 'exit':
        exit(0)
    else:
        res = model.generate(
            input=audio,
            cache={},
            language="auto",
            use_itn=True,
            batch_size_s=60,
            merge_vad=True,
            merge_length_s=15,
            output_timestamp=True,
        )

        text = rich_transcription_postprocess(res[0]["text"])
        print(f"转写结果:{text}")
执行上面的代码会自动下载模型到当前用户的.cache/modelscope/hub/models/lukeewin01/SenseVoiceSmall_HeNan路径中。如果是在无网络的机器上运行,可以先在有网络的机器上,通过执行下面的命令下载模型到本地,然后拷贝到无网络的机器上,并且把上面的模型ID替换为你无网络机器上的模型的绝对路径。
下载模型执行下面命令:
modelscope download --model lukeewin01/SenseVoiceSmall_HeNan --local_dir ./SenseVoiceSmall_HeNan
注意:你需要在当前目录中创建一个名为SenseVoiceSmall_HeHan的目录用于存放下载的模型文件。
最后把模型文件拷贝到无网络的主机上,然后修改下面的路径为你自己实际存储的模型绝对路径。
model_dir = "lukeewin01/SenseVoiceSmall_HeNan" # 把lukeewin01/SenseVoiceSmall_HeNan替换为你主机的模型所在的绝对路径
4. 模型字错率评估
这里目前只测试了训练50 epoch的字错率情况,并且已经发布到我的博客中,可以访问下面的链接查看具体的字错率情况,主要评估了训练前后对河南方言字错率变化,对普通话字错率变化,以及普通话和河南方言混合字错率变化。点击这里查看具体的字错率情况。
5. 其它
河南方言ASR模型训练视频演示:[点击这里][https://www.bilibili.com/video/BV1apRcBZEDp]
四川话方言数据集:点击这里
河南方言数据集500小时:点击这里
个人博客:https://blog.lukeewin.top
客家话ASR模型:点击这里
四川话ASR模型:点击这里