0. 模型概述
本模型基于阿里开源的 iic/speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch 模型训练,使用了 205 h 的四川话数据集。
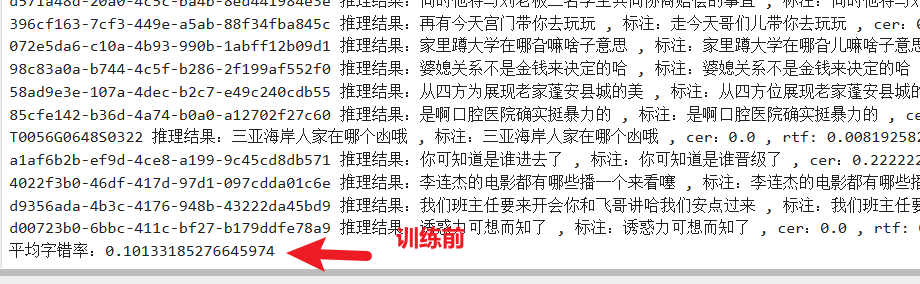
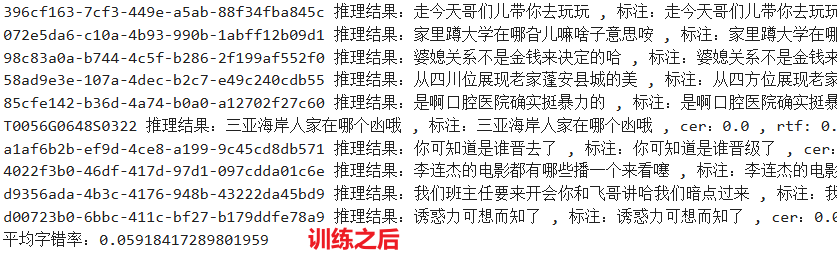
并且在训练后做了评估,字错率前后对比相差 4% ,训练之前为 10% 的字错率,训练后为 6% 的字错率。
当前开源的是训练到 3 epoch,如需要完整的 50 epoch,可以联系我 lukeewin01,需说明来意。
1. 模型介绍
Paraformer是达摩院语音团队提出的一种高效的非自回归端到端语音识别框架。本项目为Paraformer中文通用语音识别模型,采用工业级数万小时的标注音频进行模型训练,保证了模型的通用识别效果。模型可以被应用于语音输入法、语音导航、智能会议纪要等场景。
2. 模型训练
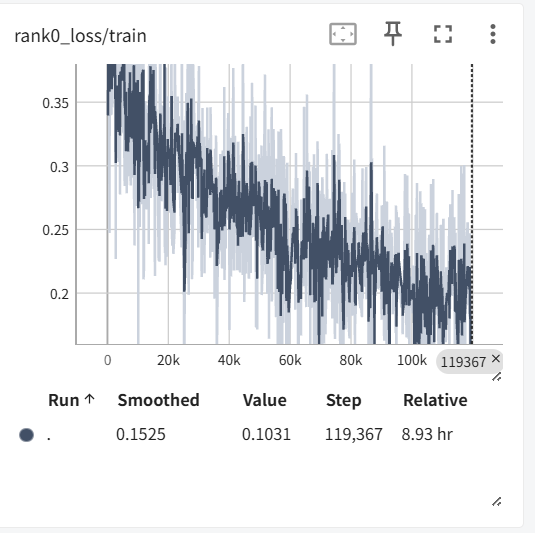
下面为训练过程中截的 loss 曲线变化图,从图中可知,这个模型训练是有效果的。
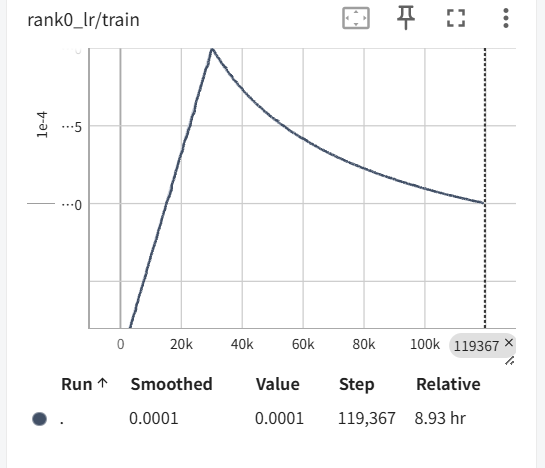
下面这图是 lr 学习率,从图可知这个学习率已经趋于平稳。
3. 模型推理
先安装 python 依赖
pip install -U funasr modelscope
安装 cuda 版本的 torch
pip uninstall torch torchaudio torchvision -y
pip install torch==2.3.1 torchvision==0.18.1 torchaudio==2.3.1 -f  https://mirrors.aliyun.com/pytorch-wheels/cu118
下面是推理代码,第一次运行会自动从 modelscope 中下载模型文件,如果是内网运行,需要把下面代码中的 model_dir 修改为模型的绝对路径。需要注意该模型不兼容 spk_model,不能直接引入 cam++ 模型实现区分说话人,如需兼容 cam++ 实现区分说话人语音识别,可联系 lukeewin01,需说明来意。
from funasr.utils.postprocess_utils import rich_transcription_postprocess
from funasr import AutoModel

model_dir = "lukeewin01/paraformer-large-sichuan-offline"

model = AutoModel(
    model=model_dir,
    disable_update=True,
    device="cuda:0",
)

def paraformer_infer(audio_path: str):
    res = model.generate(
        input=audio_path,
        cache={},
        use_itn=False,
        batch_size_s=60
    )
    text = rich_transcription_postprocess(res[0]["text"])
    return text

audio = "your_audio.wav"
print(paraformer_infer(audio))
4. 模型字错率评估
训练前,对四川话测试集测试评估字错率为 10%,如下图所示。
训练之后,对相同的四川话测试集评估字错率为 6%,如下图所示。
如何测试字错率,可以看 https://blog.lukeewin.top/archives/train-asr-model-paraformer#toc-head-4
5. 其它
四川话方言数据集:点击这里
演示视频:点击这里
个人博客:https://blog.lukeewin.top
客家话ASR模型:点击这里